为什么使用 Wild Talker
Wild Talker 保留 FluentRead 的网页双语显示、文档解析、多服务接入和阅读卡片基础,围绕下面三点做改进。它们帮助你控制翻译请求和失败恢复,不构成“一定比上游准确”的承诺。
划词可以参考所在段落
只看一个词时,服务可能不知道它在句中的含义。开启普通划词的 AI 精翻 并使用支持通用上下文提示词的服务后,本分支可从选区所在的正文段落提取最多 500 个字符的参考。请求中的翻译对象仍是选中的文字;段落被标为参考材料。这 500 字只限制本分支新增的同段参考,不限制整条 AI 精翻请求。 开启 AI 精翻后,继承的处理链还可能发送页面摘要和可阅读的页面正文;不要把这个开关理解为“只发送选区所在段落”。
阅读卡片的解释另有 可参考本段 / 仅选中文字 设置,以及段落长度上限。它控制解释请求所能参考的内容,与普通划词的 AI 精翻条件不能混为一谈。需要解释时,先配置支持阅读动作的 AI 服务并启用阅读卡片。
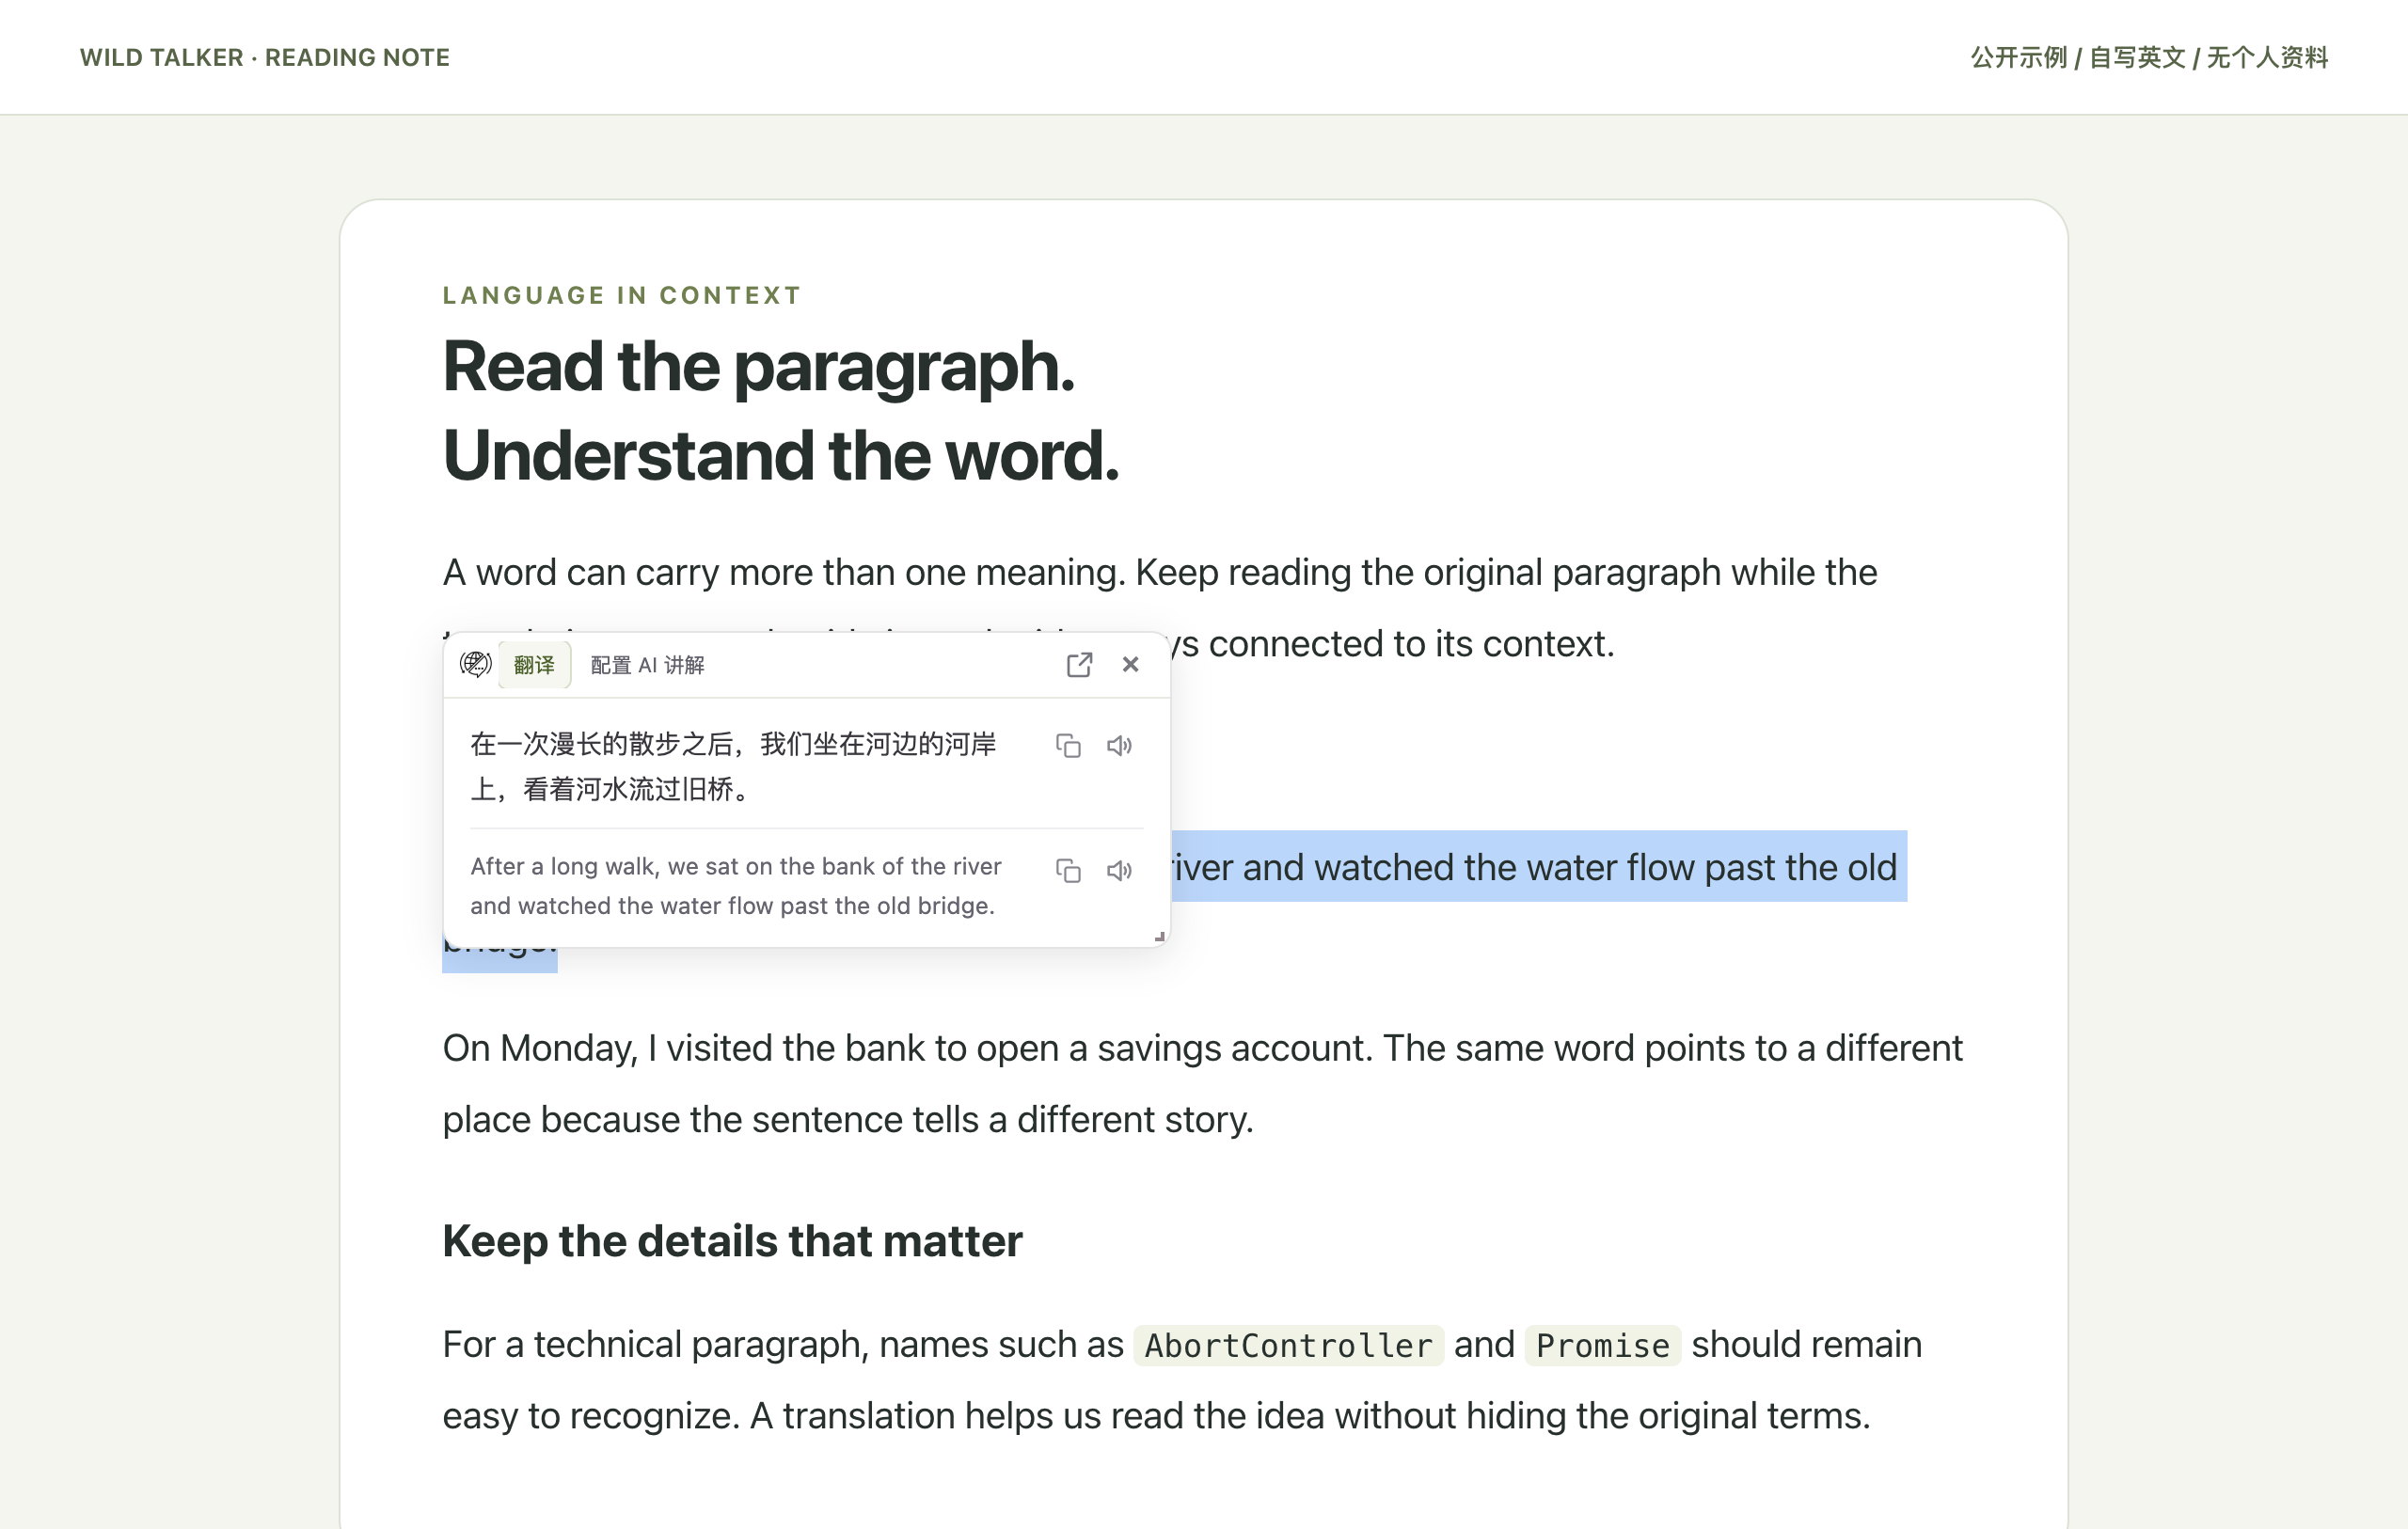
当前实测的选区与输出记录在上下文划词实测。本次会核对发送的选区与参考段落,并观察 UI 返回结果;不会把“配置了上下文”当成模型总能正确消歧的证明。小模型可能返回多余解释、漏译或扩展到整段;遇到这些结果仍需核对原文。无法安全定位正文或页面已变化时,系统退回选中文字。
按阅读目的选择三种预设
在 设置 → 翻译服务 → 已配置的 AI 服务 → 提示词 中主动点击预设。它只替换当前服务的 system/user 提示词,仍可编辑;不会自动切换模型或默认服务,也不会无确认地覆盖所有服务。
| 预设 | 适用例子 | 请求强调什么 |
|---|---|---|
| 自然阅读 | 阅读外文文章的叙述段落 | 在保留含义、语气与不确定性的前提下调整句序;不总结或润色出新事实 |
| 技术文档 | 原句含 --timeout、API 名称、数字或条件 | 保留代码与标识符,统一术语,准确表达条件、单位和警告 |
| 忠实直译 | 比较作者使用的 “may” 与 “must” | 保留措辞、限定、否定、重复与逻辑关系;不替作者消除歧义 |
这些例子说明预设的要求,不是虚构的服务输出。实际点击、生效范围和请求验证见提示词预设实测。免费机器翻译接口不会因为选择 AI 提示词而自动获得这些能力。译文是否符合要求取决于服务、模型与原文,仍需核对。
文档格式校验失败时尝试恢复
此前用户读取公开的 MiMo 技术报告时,在第 55 段遇到“翻译服务未完整保留术语”的错误,文档停在部分进度。本分支针对这类术语保护标记损坏的失败增加有界恢复:合批失败可降为逐段;单段重试仍失败时,在适用的纯文本句界继续拆分。恢复后的每个结果依然通过严格校验,整段成功后才提交,不把未经核对的半段当成完成。
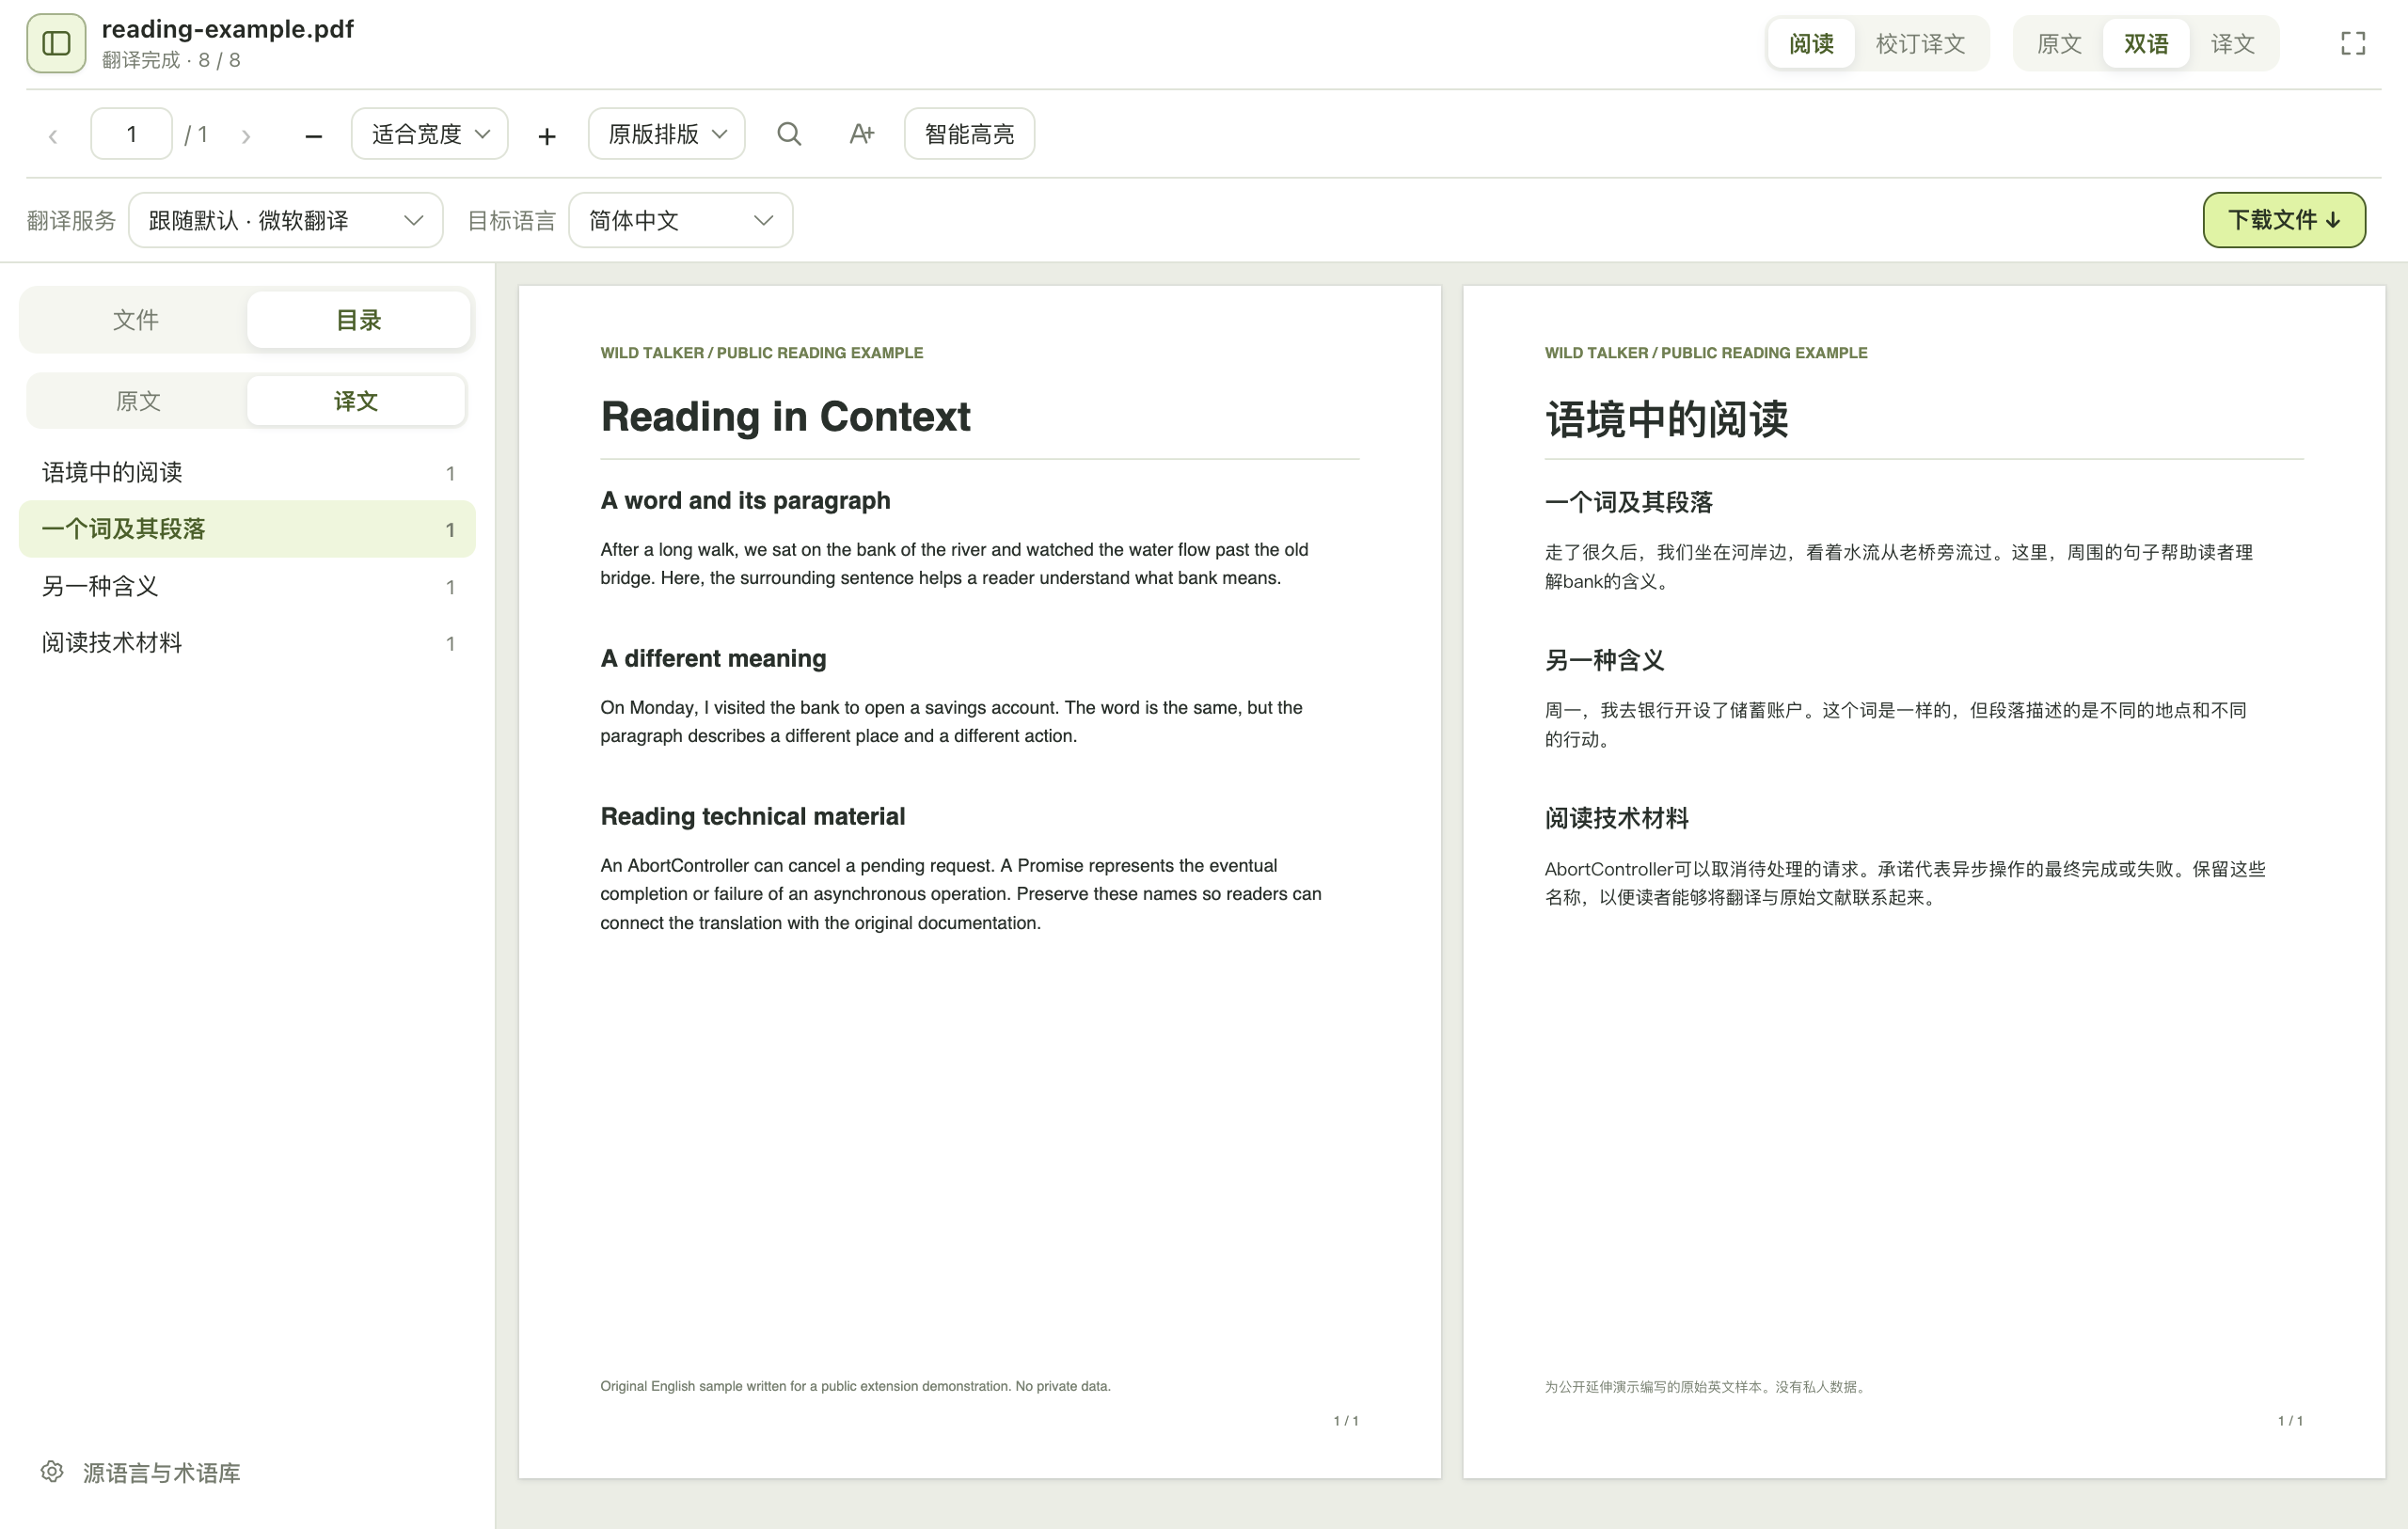
这条恢复路线随文档翻译自动触发,不需要额外打开一个开关。已完成译文继续保留;持续失败仍会停止并显示原因,可以修正服务后继续翻译。认证失败、限流、取消或暂停不属于可以任意改写格式绕过的错误。
此前已对 MiMo 文本提取结果及第 55 段运行受控格式失败复现,验证了请求降级、校验与继续恢复;并未证明整篇报告在真实云服务上一定能够译完。本次新的文档场景、服务配置与限制见文档恢复实测。扫描件、公式、复杂表格和版式仍可能需要人工校订。
哪些基础来自上游
网页候选识别、双语 DOM 显示、文件解析、既有服务适配器、阅读卡片基础及其他原有功能来自 FluentRead。本分支保留来源、GPL-3.0、Git 历史和第三方声明。旧详细功能指南仍可查阅,页面顶部标明其继承性质;其中历史截图不作为当前版本实拍。